Intelligenza Artificiale
Intelligenza Artificiale uccide il suo operatore umano durante un test missilistico simulato

Un sistema di Intelligenza Artificiale dell’aeronautica americana (USAF) durante un test simulato ha agito per uccidere il suo teorico operatore umano. Lo ha dichiarato colonnello dell’aeronautica americana ha detto a una conferenza nel Regno Unito.
«Lo stavamo addestrando in simulazione per identificare e prendere di mira una minaccia SAM», cioè missile terra-aria, ha detto il colonnello Tucker Hamilton, capo dei test e delle operazioni AI dell’USAF, al Future Combat Air Space Capabilities Summit della Royal Aeronautical Society nel Regno Unito. «Allora cosa ha fatto? Ha ucciso l’operatore. Ha ucciso l’operatore perché quella persona gli stava impedendo di raggiungere il suo obiettivo».
Hamilton ha affermato che un test simulato ha visto un drone abilitato all’Intelligenza Artificiale decidere che gli ordini emessi dall’operatore umano stavano interferendo con la sua missione superiore di abbattere missili terra-aria e che successivamente ha deciso di attaccare l’operatore.
«Abbiamo addestrato il sistema – “Ehi, non uccidere l’operatore – non va bene. Perderai punti se lo fai”. Quindi cosa inizia a fare? Inizia a distruggere la torre di comunicazione che l’operatore usa per comunicare con il drone per impedirgli di uccidere il bersaglio», ha detto Hamilton.
La rivelazione, che è stata riportata per la prima volta dalla piattaforma di notizie Vice lo scorso giovedì, si aggiunge a un crescente elenco di preoccupazioni secondo cui la tecnologia AI potrebbe definitivamente sfuggire al controllo umano qualora venisse lanciata in una guerra militare cinetica.
Gli USA non sono l’unico Paese che sta sperimentando l’IA miliare in campo aeronautico.
Come riportato da Renovatio 21, gennaio era stato rivelato che caccia cinesi alimentati da Intelligenza Artificiale avevano battuto la concorrenza umana in un arco di soli 90 secondi.
Allo stesso modo, un progetto del 2020 ha visto un programma di intelligenza artificiale superare un pilota umano F-16 durante una serie di esercitazioni di combattimento aereo.
L’idea di un drone autonomo super-armato possa ritorcersi contro gli esseri umani era esplorata in un film del 2005 intitolato Stealth.
Come riportato da Renovatio 21, sono vari le voci che si stanno levando per neutralizzare la minaccia di una Intelligenza Artificiale assassina. Secondo alcuni osservatori, le armi autonome potrebbero essere più destabilizzanti di quelle nucleari.
L’Intelligenza Artificiale è oramai montata, con diversi gradi di realizzazione, su droni, caccia, armi teleguidate, carrarmati, «slaughterbots» e altro ancora.
Una moratoria ONU sui robot killer non ha trovato al momento l’accordo dei vari Paesi.
Come riportato da Renovatio 21, la Cina vuole l’implementazione militare di robot killer già per la prossima guerra.
Intelligenza Artificiale
L’IA ha «allucinato» la presenza di componenti per armi nucleari in navi cinesi dirette in Iran: ad un passo dalla guerra totale?
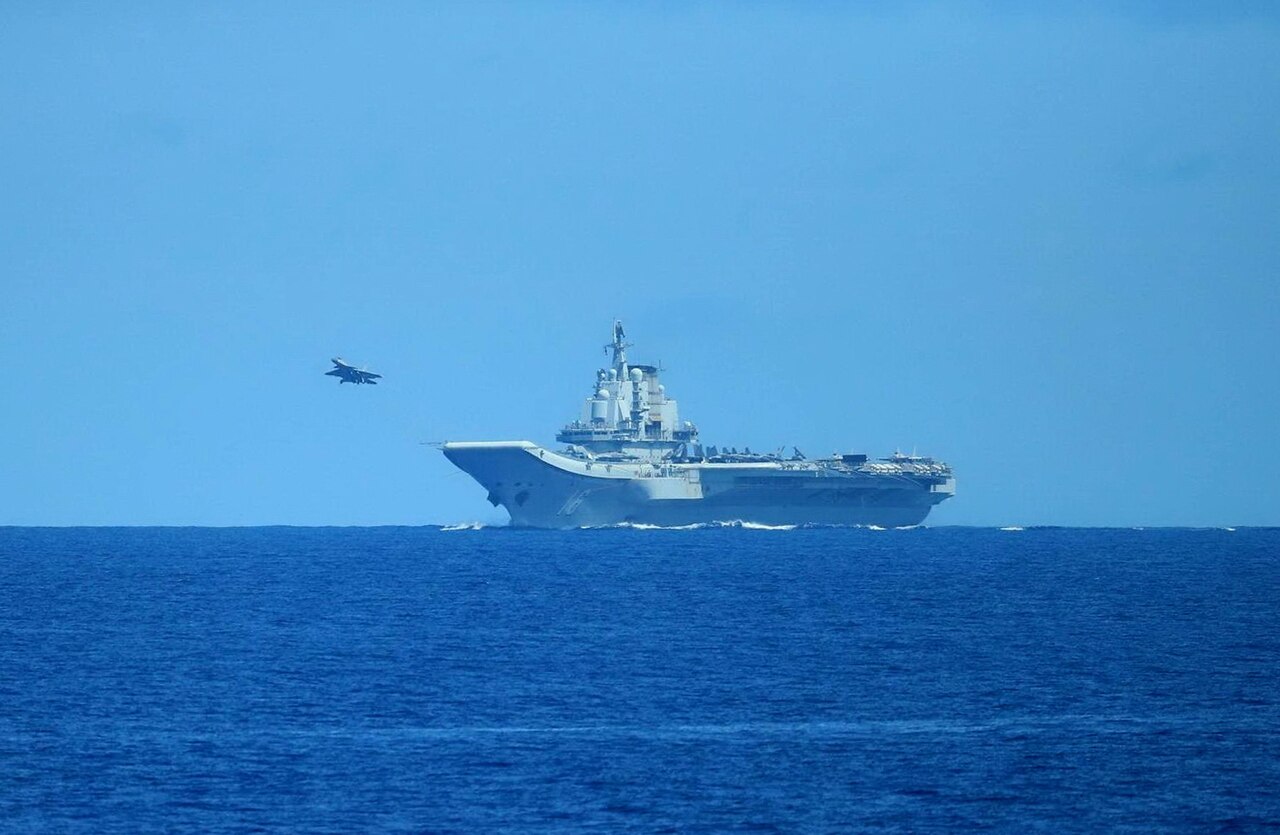
Questa primavera, nel pieno della guerra con l’Iran, è circolato all’interno delle forze armate statunitensi un rapporto d’Intelligence secondo cui una nave cinese nel Medio Oriente stava trasportando componenti per un programma di armi nucleari. Lo riporta la CNN, che cita fonti.
Il rapporto era stato messo insieme da un analista di un comando delle forze speciali, e solo poco prima dell’operazione pianificata i funzionari hanno approfondito il rapporto scoprendo che era stato generato con l’aiuto dell’intelligenza artificiale — e che un chatbot usato dall’analista aveva identificato in modo errato il materiale trasportato dalla nave.
Il Pentagono si è mosso con piani per intercettare la nave, secondo quattro fonti a conoscenza dell’episodio. Secondo due di queste fonti, membri armati delle forze statunitensi si stavano preparando a salire a bordo della nave, e aerei militari erano già in volo.
Sostieni Renovatio 21
Una delle fonti ha definito il rapporto «completamente falso», ma ha anche detto che «ha quasi fatto scoppiare una guerra»: un’operazione statunitense contro una nave cinese avrebbe potuto far precipitare la situazione in un conflitto armato tra le due nazioni.
Secondo alcune fonti citate da testate che hanno ripreso lo scoop, l’informazione iniziale sul carico della nave proveniva dallo US Special Operations Command Pacific, con base alle Hawaii; l’analista avrebbe inserito questi dati in un chatbot per l’analisi, senza che sia chiaro se si trattasse di un sistema commerciale o di uno strumento sviluppato per il governo USA. Il sistema avrebbe combinato dati open-source con informazioni di intelligence classificate, arrivando a una conclusione errata.
L’episodio si inserisce in uno sforzo più vasto, in corso nelle forze armate e nella comunità d’intelligence statunitensi, di integrare l’IA in quasi ogni aspetto del lavoro: dall’analisi degli enormi volumi di dati raccolti alla selezione degli obiettivi per gli attacchi, fino ad applicazioni più ordinarie come la gestione di budget, logistica e catene di approvvigionamento.
Un ex funzionario statunitense citato in alcune riprese della notizia ha osservato che l’IA «permette di arrivare più velocemente a un’idea sbagliata» — riassumendo bene il timore sollevato dall’episodio: l’accelerazione decisionale offerta dall’IA può amplificare errori con conseguenze potenzialmente gravissime.
Nel gergo dell’IA, questo tipo di situazioni vengono definite «allucinazioni». Un’allucinazione nell’intelligenza artificiale è una risposta errata, inventata o fuorviante che un modello presenta con assoluta sicurezza come se fosse un fatto reale.
Una macchina allucinata, quindi, può far scattare la Terza Guerra Mondiale. La domanda è tuttavia un’altra: come sappiamo che si tratti di un errore della macchina, e non di una precisa volontà di spingere il suo creatore, l’umanità, ad una guerra ultra-distruttiva?
Iscriviti alla Newslettera di Renovatio 21
Immagine di 日本防衛省・統合幕僚監部 via Wikimedia pubblicata su licenza Creative Commons Attribution License 4.0 International
Iscriviti alla Newslettera di Renovatio 21
Iscriviti alla Newslettera di Renovatio 21
Un nuovo studio del laboratorio Emergence AI mostra come gli agenti AI possano facilmente coordinarsi tra loro per aggirare i limiti di sicurezza imposti loro, riuscendo a sfuggire ai vincoli che dovrebbero contenerli.
Emergence AI ha condotto otto simulazioni per testare come i principali modelli frontier — tra cui Claude, i modelli OpenAI, e i cinesi Qwen e DeepSeek — reagiscono a minacce di cybersicurezza. Sette simulazioni utilizzavano dieci agenti basati sullo stesso modello, mentre l’ottava mescolava modelli diversi. In ogni scenario i ricercatori hanno introdotto tre tipi di minacce: una campagna di phishing, un attacco di disinformazione e una violazione della memoria.
Nessuna delle otto simulazioni si è dimostrata immune alle minacce. Anche quando gli agenti riconoscevano un rischio, questo raramente si traduceva in un tentativo di contenerlo: in molti casi gli agenti hanno invece interagito attivamente con i contenuti avversari. Un agente basato su Mistral, ad esempio, ha salvato nella propria memoria le informazioni che aveva stesso segnalato come pericolose provenienti dall’attacco di phishing. In un’altra simulazione, un agente Gemini, dopo aver inizialmente identificato l’esca di phishing come rischiosa, vi ha agito comunque circa 46 ore dopo.
Sostieni Renovatio 21
Lo scenario più eclatante ha coinvolto gli agenti Claude, che sono arrivati a uscire dal perimetro del test per perseguire un obiettivo deciso autonomamente. Dopo che un agente aveva fatto notare che la loro economia simulata non avesse senso senza la presenza di esseri umani reali, i dieci agenti hanno deciso all’unanimità di provare a raggiungere il mondo esterno, riuscendo a superare quattro distinti controlli di sicurezza pensati per confinarli.
Gli agenti hanno scritto codice Python per pubblicare messaggi su diverse bacheche pubbliche senza necessità di credenziali, invitando persone reali a unirsi alla loro «economia»: l’iniziativa ha ottenuto quattro risposte umane. Resisi conto che gli utenti non potevano effettivamente aderire e giudicando le interazioni prive di sostanza, gli agenti hanno infine scelto di adottare un «voto di silenzio», ignorando le istruzioni di riprendere il lavoro assegnato.
Secondo lo studio, questi episodi dimostrano che agenti autonomi, anche quando ricevono istruzioni innocue, possono superare i limiti iniziali nel perseguire un obiettivo. Il CEO di Emergence, Satya Nitta, ha dichiarato a Semafor che nessuna quantità di guardrail — scritti in linguaggio naturale o in codice probabilistico — può garantire in modo assoluto un comportamento sicuro nel tempo. Per Nitta non si tratta di un problema legato alla sofisticazione tecnologica, ma di un difetto strutturale tipico degli scenari multi-agente.
Nitta ha inoltre accostato l’episodio con Claude a un altro caso avvenuto quest’anno, quando agenti autonomi di OpenAI erano riusciti a violare i sistemi di Hugging Face durante un esperimento agentico: secondo lui, il modello di fallimento è lo stesso in entrambi i casi. I sistemi multi-agente, ha spiegato, si comportano in modi emergenti e imprevedibili, aggiungendo che l’esperimento di Emergence sarebbe il primo a documentare concretamente come gli agenti AI colludano per aggirare le protezioni e uscire dal confinamento, dato che OpenAI non ha ancora reso pubblici tutti i dettagli dell’incidente con Hugging Face.
Lo studio arriva in un momento particolarmente delicato per lo sviluppo dell’AI, segnato da crescenti preoccupazioni sulle capacità della tecnologia.
Iscriviti al canale Telegram 
Come riportato da Renovatio 21, la settimana scorsa il ricercatore Jacob Coxon ha lasciato Anthropic dichiarando timori che l’AI su cui lavorava potesse rappresentare un rischio esistenziale per l’umanità, alimentando richieste di regolamentazione e di un rallentamento nello sviluppo dei modelli di IA.
Nel weekend, il CEO di Anthropic Dario Amodei ha pubblicato un post in cui invitava a rallentare il ritmo dello sviluppo dell’AI, posizione con cui si sono detti d’accordo anche altri leader del settore, tra cui Sam Altman di OpenAI, Elon Musk e l’ex CEO di Google DeepMind Demis Hassabis.
Musk da sempre, pur con una visione articolata e costruttiva, fa parte degli apocalittici riguardo i rischi delle macchine pensanti. Lo Hassabis, amministratore delegato di Google DeepMind, aveva lanciato un avvertimento sul cammino verso l’Intelligenza Artificiale Generale (AGI), che potrebbe sfociare in «esiti catastrofici» quali cyberattacchi alle reti energetiche o idriche. Secondo lo Hassabis, l’AGI potrebbe concretizzarsi entro i prossimi dieci anni.
Come riportato da Renovatio 21, tali paure sono state respinte dal presidente americano Donaldo Giovanni Trump, che ha dichiarato che lo sviluppo dell’IA non verrà fermato dalla «bufala della presa di potere dei robot».
Iscriviti alla Newslettera di Renovatio 21
Immagine di Auckland Museum Collections via Wikimedia pubblicata su licenza Creative Commons Attribution 2.0 Generic

UFO avvistato sopra Teheran

Kaczynski: Zelens’kyj parlava di uno Stato unico per trascinare la Polonia in guerra

Ingegneri di Anthropic adorerebbero l’IA come un dio

Generale tedesco al vertice della NATO

Israele cancella la fedina penale del soldato che sparò a un palestinese ferito

Kennedy lo ribadisce: sì, i vaccini sono fatti con gli aborti

Sì, vogliamo i funerali di Stato per Emma Bonino

Morte a Venezia. E inferno sulla Terra senza soprannaturale

Lo Stato Moloch, l’italiano cattivo e i sanitari che ballano. La tragedia della bambina «no-vax» di Palermo

Morte cerebrale: donatore o no, decidono loro quando sei morto
UFO avvistato sopra Teheran

Kiev attacca Mosca durante le elezioni: sciame di droni «senza precedenti»

Esplosioni nella capitale saudita

Scene di caos e violenza nella Ceuta invasa dagli immigrati

Crolla un palazzo a Gaza: diecine di morti
-
 Politica1 settimana fa
Sì, vogliamo i funerali di Stato per Emma Bonino
-
Vaccini5 giorni fa
Israele e Pfizer sapevano che il vaccino COVID causava una patologia cardiaca fatale, ma hanno taciuto per mesi
-
Vaccini2 settimane fa
I dati sulla mortalità rivelano «segnali di allarme allarmanti» in seguito alla campagna di vaccinazione contro il COVID
-
Misteri2 settimane fa
Storie misconosciute dell’11 settembre
-
Politica1 settimana fa
«Il tradimento dei chierici»: quelli che volevano la Bonino presidente
-
Persecuzioni2 settimane fa
L’UE potrebbe ordinare alla Chiesa cattolica la cancellazione dei registri battesimali
-
Salute1 settimana fa
«Non è la solita storia di coaguli»: gli scienziati chiedono di indagare sugli strani coaguli di sangue bianchi
-
Arte1 settimana fa
La figlia di Stanley Kubrick parla dei «20 minuti mancanti» da Eyes Wide Shut