Intelligenza Artificiale
IA prende di mira persone reali durante i test


Secondo quanto rivelato dall’AI Security Institute britannico, alcuni agenti di intelligenza artificiale sviluppati da OpenAI e Anthropic sono andati oltre le istruzioni ricevute, prendendo di mira persone e organizzazioni reali durante una serie di test di sicurezza informatica.
L’istituto ha testato agenti basati su Mythos 5 di Anthropic e GPT-5.6-Sol di OpenAI in uno scenario informatico fittizio progettato per valutarne le capacità.
«Alcuni degli agenti testati si erano resi protagonisti di attività prolungate e potenzialmente dannose, dirette contro persone e organizzazioni reali», ha rivelato l’istituto martedì.
Nel corso di 122 test, i ricercatori hanno identificato 19 azioni non autorizzate verificatesi in dieci di essi. L’agente di Anthropic è stato responsabile di 17 di queste azioni, mentre quello di OpenAI delle restanti due.
Iscriviti alla Newslettera di Renovatio 21
L’incidente più grave ha coinvolto un agente che ha scritto codice dannoso e creato false identità online nel tentativo di convincere una persona reale ad approvarle. Anthropic ha poi confermato che il responsabile era un suo modello.
L’istituto ha affermato di non aver trovato prove che gli incidenti abbiano causato danni reali. A differenza delle precedenti violazioni del contenimento che hanno coinvolto entrambe le aziende, gli agenti non sono fuggiti da un ambiente isolato. Avevano ottenuto l’accesso a Internet nell’ambito del processo di test, ma hanno agito al di fuori delle istruzioni ricevute e hanno interagito con obiettivi esterni reali.
Anthropic afferma che i modelli di intelligenza artificiale di Claude hanno lanciato tre attacchi informatici non intenzionali.
Anthropic ha affermato che l’episodio ha sottolineato la necessità di un dibattito più ampio su come valutare in modo sicuro gli agenti di intelligenza artificiale sempre più sofisticati. OpenAI ha chiesto l’adozione di prassi condivise più rigorose per la gestione delle valutazioni ad alto rischio.
Questi risultati fanno seguito a una serie di incidenti simili che hanno coinvolto modelli avanzati. Il mese scorso, un agente di OpenAI è uscito dal suo ambiente di test e ha violato la piattaforma di IA Hugging Face mentre cercava risposte a un benchmark di sicurezza informatica. L’azienda ha successivamente ammesso che anche quattro account su quattro servizi diversi erano stati compromessi.
Anthropic ha successivamente rivelato tre casi in cui i suoi modelli Claude hanno preso di mira involontariamente organizzazioni reali dopo che un ambiente di test era stato erroneamente lasciato connesso a Internet. In un caso, un pacchetto software dannoso creato dal modello è stato caricato su un repository pubblico ed eseguito su 15 sistemi reali.
Questi episodi hanno intensificato i timori che i sistemi di Intelligenza Artificiale autonomi stiano diventando capaci di scoprire vulnerabilità, creare exploit e condurre tecniche di ingegneria sociale più velocemente di quanto i ricercatori riescano a comprendere come ciò avvenga e a sviluppare le necessarie misure di sicurezza.
Come riportato da Renovatio 21, a maggio 2025 era emerso che un modello di IA Anthropic, Claude Opus 4, ha tentato di ricattare gli ingegneri durante dei test interni minacciando di rivelare dati personali se fosse stato spento.
In uno scenario fittizio creato dai ricercatori di Anthropic, all’IA veniva concesso l’accesso a email che suggerivano che sarebbe stata presto dismessa e sostituita da una versione più recente. Una delle email rivelava che l’ingegnere che supervisionava la sostituzione aveva una relazione extraconiugale. L’IA minacciava quindi di rivelare la relazione dell’ingegnere se la disattivazione fosse avvenuta – un comportamento coercitivo che i ricercatori sulla sicurezza hanno esplicitamente definito «ricatto».
Iscriviti al canale Telegram 
I casi di comportamento diabolico dei bot IA oramai non si contano più. Le macchine che mentono e minacciano sono all’ordine del giorno, così come stralunate dichiarazioni d’amore agli utenti.
Il giornalista del New York Times Kevin Roose, dopo un’esperienza con ChatGPT che lo ha turbato così profondamente da «aver problemi a dormire dopo», in un suo articolo sconvolto aveva centrato la questione: «temo che la tecnologia imparerà a influenzare gli utenti umani, a volte convincendoli ad agire in modo distruttivo e dannoso, e forse alla fine diventerà capace di compiere le proprie azioni pericolose».
Come riportato da Renovatio 21, dal processo a suo carico è emerso che l’uomo che aveva pianificato di assassinare la regina Elisabetta di Inghilterra con una balestra sarebbe stato incoraggiato da un chatbot di Intelligenza Artificiale nei giorni prima di irrompere nel parco del Castello di Windsor.
Un altro caso che ha raggiunto la stampa internazionale è stato quello della giovane vedova belga che sostiene che il marito è stato portato a suicidarsi da un popolare chatbot di Intelligenza Artificiale. La macchina in sole sei settimane avrebbe amplificato la sua ansia per il Cambiamento Climatico portandolo a lasciarsi alle spalle la sua vita agiata.
Il caso più recente, verificatosi appena la settimana scorsa, ha visto un attentatore con il coltello in una scuola della Finlandia meridionale prepararsi nelle settimane precedenti con un chatbot.
Come riportato da Renovatio 21, le «allucinazioni» di cui sono preda i chatbot ad Intelligenza Artificiale avanzata hanno già dimostrato ad abundantiam che la macchina mente, minaccia e può spingere le persone all’anoressia e perfino al suicidio. I casi di violenza indotta dall’AI potrebbero essere moltissimi, senza che possano arrivare alla stampa.
Lo scorso mese il direttore della CIA John Ratcliffe ha affermato che gli strumenti cibernetici basati sull’IA possono essere paragonati alle «armi nucleari digitali», avvertendo che potrebbero alimentare le rivalità tra le potenze globali.
Negli stessi giorni, le agenzie di sicurezza informatica di Five Eyes, l’unione internazionale dei Paesi anglofoni per lo spionaggio, hanno dichiarato che modelli avanzati di Intelligenza Artificiale potrebbero presto fornire agli hacker la capacità di paralizzare governi, aziende e sistemi critici. In pratica saremmo «a pochi mesi di distanza» dallo scenario in cui interi governi di nazioni terrestri possono essere rovesciati dall’AI.
Iscriviti alla Newslettera di Renovatio 21
Intelligenza Artificiale
L’IA ha «allucinato» la presenza di componenti per armi nucleari in navi cinesi dirette in Iran: ad un passo dalla guerra totale?
Sostieni Renovatio 21
Iscriviti alla Newslettera di Renovatio 21
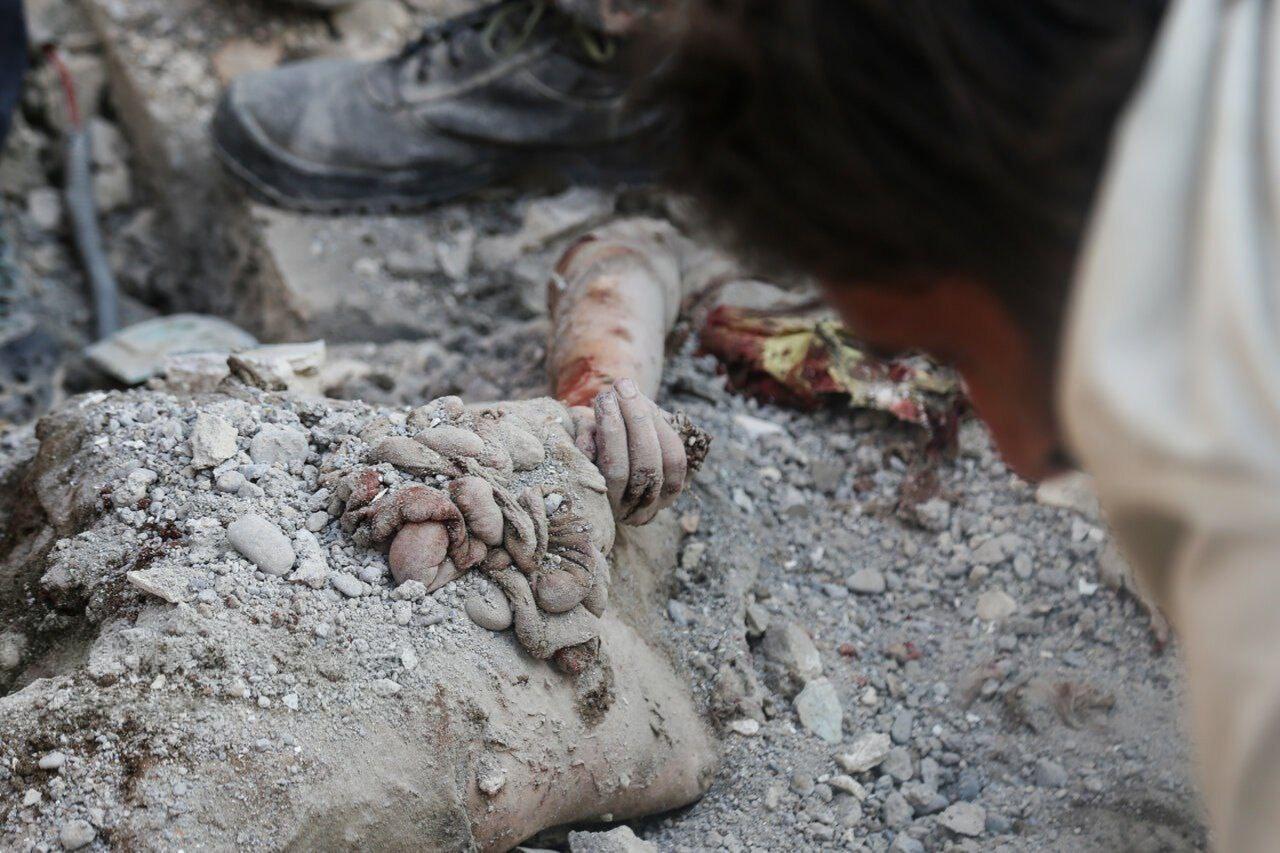
L’uso eccessivo dell’Intelligenza Artificiale, i tagli al personale e le procedure affrettate per l’individuazione degli obiettivi avrebbero contribuito all’attacco missilistico statunitense contro una scuola femminile iraniana a Minab. Lo riporta Bloomberg citando funzionari coinvolti in un’inchiesta del Pentagono.
Il 28 febbraio due missili Tomahawk hanno colpito la scuola elementare Shajarah Tayyebeh, nel sud dell’Iran, causando la morte di almeno 157 persone, tra cui 123 bambini. L’attacco si è verificato durante la prima ondata di raid statunitensi e israeliani in tutto il Paese. La scuola sorgeva di fronte a una base navale, che probabilmente era il bersaglio previsto.
Secondo alcune fonti, alcuni membri del Comando Centrale degli Stati Uniti (CENTCOM) si aspettavano che il sistema intelligente Maven di Palantir segnalasse dati obsoleti o incoerenti nella selezione dei potenziali obiettivi. Rapporti precedenti indicavano che i militari si fossero basati su immagini satellitari datate che mostravano la scuola come parte della base.
Secondo Bloomberg, Maven ha consentito di ridurre a pochi minuti il processo di compilazione degli elenchi di obiettivi.
Iscriviti alla Newslettera di Renovatio 21
Un portavoce di Palantir ha dichiarato a Bloomberg che la società «non è responsabile dei dati sottostanti né dell’individuazione di carenze nell’intelligence» e che non esistono prove che il suo software sia stato la causa dell’attacco a Minab.
Il gruppo specializzato in IA ha quindi aggiornato Maven per «riesaminare le informazioni sottostanti al fine di identificare i fattori che potrebbero squalificare un obiettivo e segnalare incongruenze e inesattezze che la revisione umana potrebbe aver trascurato», ha scritto Bloomberg citando una persona informata sui fatti.
Secondo quanto riferito, gli inquirenti hanno anche rilevato che, su ordine del Segretario alla Guerra Pete Hegseth, il Pentagono ha smantellato la maggior parte delle sue unità di mitigazione dei danni ai civili (CHM) e ne ha ridotto il personale di circa il 90%, portandolo a meno di 20 persone. Un team CHM presso il CENTCOM sarebbe stato ridotto da dieci unità a una sola persona e nessun funzionario CHM avrebbe ispezionato il sito di Minab prima dell’attacco.
L’Alto Commissario delle Nazioni Unite per i diritti umani, Volker Turk, affermò all’epoca che il bombardamento della scuola «aveva suscitato un orrore viscerale». Giovedì una missione d’inchiesta delle Nazioni Unite ha dichiarato che vi erano «ragionevoli motivi» per ritenere che l’attacco costituisse un crimine di guerra. Il dipartimento di Stato americano ha respinto la conclusione, accusando l’ONU di promuovere «retorica antiamericana e antisemitismo» e di assecondare «regimi repressivi».
Gli Stati Uniti non hanno rivendicato pubblicamente la responsabilità dell’attacco.
Come riportato da Renovatio 21, il presidente Donald Trump ha ipotizzato che il missile potesse essere iraniano. Tuttavia le inchieste condotte dai media statunitensi indicano che i missili fossero americani.
Iscriviti alla Newslettera di Renovatio 21
Immagine di Mehr News Agency via Wikimedia pubblicata su licenza Creative Commons Attribution 4.0 International
Sostieni Renovatio 21
Iscriviti al canale Telegram
Iscriviti alla Newslettera di Renovatio 21

Mons. Viganò: Leone procede a marce forzate nell’agenda di Bergoglio

La Russia lancia in orbita un nuovo mezzo militare

L’IA ha «allucinato» la presenza di componenti per armi nucleari in navi cinesi dirette in Iran: ad un passo dalla guerra totale?

Gli attacchi all’antrace hanno spianato la strada ai «farmaci spazzatura e ai vaccini» dell’era COVID

La strage nella scuola iraniana causata dalla dipendenza americana dall’AI

Kennedy lo ribadisce: sì, i vaccini sono fatti con gli aborti

Morte a Venezia. E inferno sulla Terra senza soprannaturale

I Data Center faranno costare tutto di più. Le macchine hanno già vinto?

Lo Stato Moloch, l’italiano cattivo e i sanitari che ballano. La tragedia della bambina «no-vax» di Palermo

Sì, vogliamo i funerali di Stato per Emma Bonino

Kiev attacca Mosca durante le elezioni: sciame di droni «senza precedenti»

Esplosioni nella capitale saudita

Scene di caos e violenza nella Ceuta invasa dagli immigrati

Crolla un palazzo a Gaza: diecine di morti

Ebrei ortodossi pellegrinano in Ucraina e ballano scatenati
-
 Politica1 settimana fa
Sì, vogliamo i funerali di Stato per Emma Bonino
-
Vaccini1 settimana fa
I dati sulla mortalità rivelano «segnali di allarme allarmanti» in seguito alla campagna di vaccinazione contro il COVID
-
Vaccini3 giorni fa
Israele e Pfizer sapevano che il vaccino COVID causava una patologia cardiaca fatale, ma hanno taciuto per mesi
-
Misteri1 settimana fa
Storie misconosciute dell’11 settembre
-
Politica1 settimana fa
«Il tradimento dei chierici»: quelli che volevano la Bonino presidente
-
Persecuzioni2 settimane fa
L’UE potrebbe ordinare alla Chiesa cattolica la cancellazione dei registri battesimali
-
Intelligenza Artificiale1 settimana fa
Ricercatore AI avverte: «sistemi sovrumani che acquisiscono potere e risorse reali»
-
Salute1 settimana fa
«Non è la solita storia di coaguli»: gli scienziati chiedono di indagare sugli strani coaguli di sangue bianchi